من صورة HEIF إلى مستودعات OpenAI الداخلية: سلسلة ثغرات بدأت في libheif وانتهت بالاستيلاء على حسابات ChatGPT وCodex
ملف صورة واحد كان كافيًا لفتح مسار هجومي بدأ داخل نظام معالجة الصور في منتدى OpenAI، ثم خرج من حدود Discourse بالكامل. الثغرة الأولى لم تكن في التطبيق نفسه، بل في مكتبة معالجة صور منخفضة المستوى هي libheif، حيث مكّن خلل في الذاكرة من الوصول إلى تنفيذ أوامر عن بُعد عبر صورة يرفعها المستخدم.
لكن الجزء الأخطر لم يكن RCE بحد ذاته. بعد السيطرة على بيئة المنتدى community.openai.com، استُخدم خلل منفصل في تكامل OpenAI SSO لتحويل اختراق المنتدى إلى وصول إلى حسابات ChatGPT وCodex لموظفين في OpenAI. ومن هناك، وبسبب الخدمات المتصلة بهذه الحسابات، أصبح الوصول النظري يمتد إلى تكاملات مثل GitHub وSlack والبريد الإلكتروني.
فريق Hacktron قال إن الرحلة من الاكتشاف الأولي إلى إثبات الوصول إلى مستودع داخلي لدى OpenAI استغرقت أقل من 72 ساعة، وإنهم أثبتوا الأثر بإنشاء Pull Request غير ضار داخل المستودع الداخلي openai/openai عبر حساب Codex تابع لأحد الموظفين، ثم أوقفوا الاختبار.
#TL;DR
- استغل باحثو Hacktron خللًا في
libheifضمن مسار معالجة صورHEIC/HEIFفيDiscourseللوصول إلىRemote Code Execution (RCE). - صورة يتحكم بها المهاجم كانت تمر عبر
ImageMagick، ما عرّض محللlibheifمباشرة لملف غير موثوق. - صورة Docker الخاصة بـ
Discourseكانت مبنية علىDebian 12وتحتوي علىlibheif 1.19.7المتأثرة، بينما كانDebian 13يشحن1.19.8في ذلك الوقت. - بعد اختراق المنتدى، استُغل خلل منفصل في
OpenAI SSOللوصول إلى حساباتChatGPTوCodex، ثم إلى تكاملات متصلة مثلGitHub. - لإثبات الأثر دون قراءة كود داخلي، استُخدم
Codexالخاص بأحد موظفي OpenAI لفتح Pull Request غير ضار داخل المستودع الداخليopenai/openai. - أصدرت
Discourseالإصلاح وأعلنت التنبيهGHSA-vhm9-85gw-x335، بينما أوصى الباحثون بتحديثlibheifوlibde265وعزل مسارات معالجة الصور غير الموثوقة داخل Sandboxes.
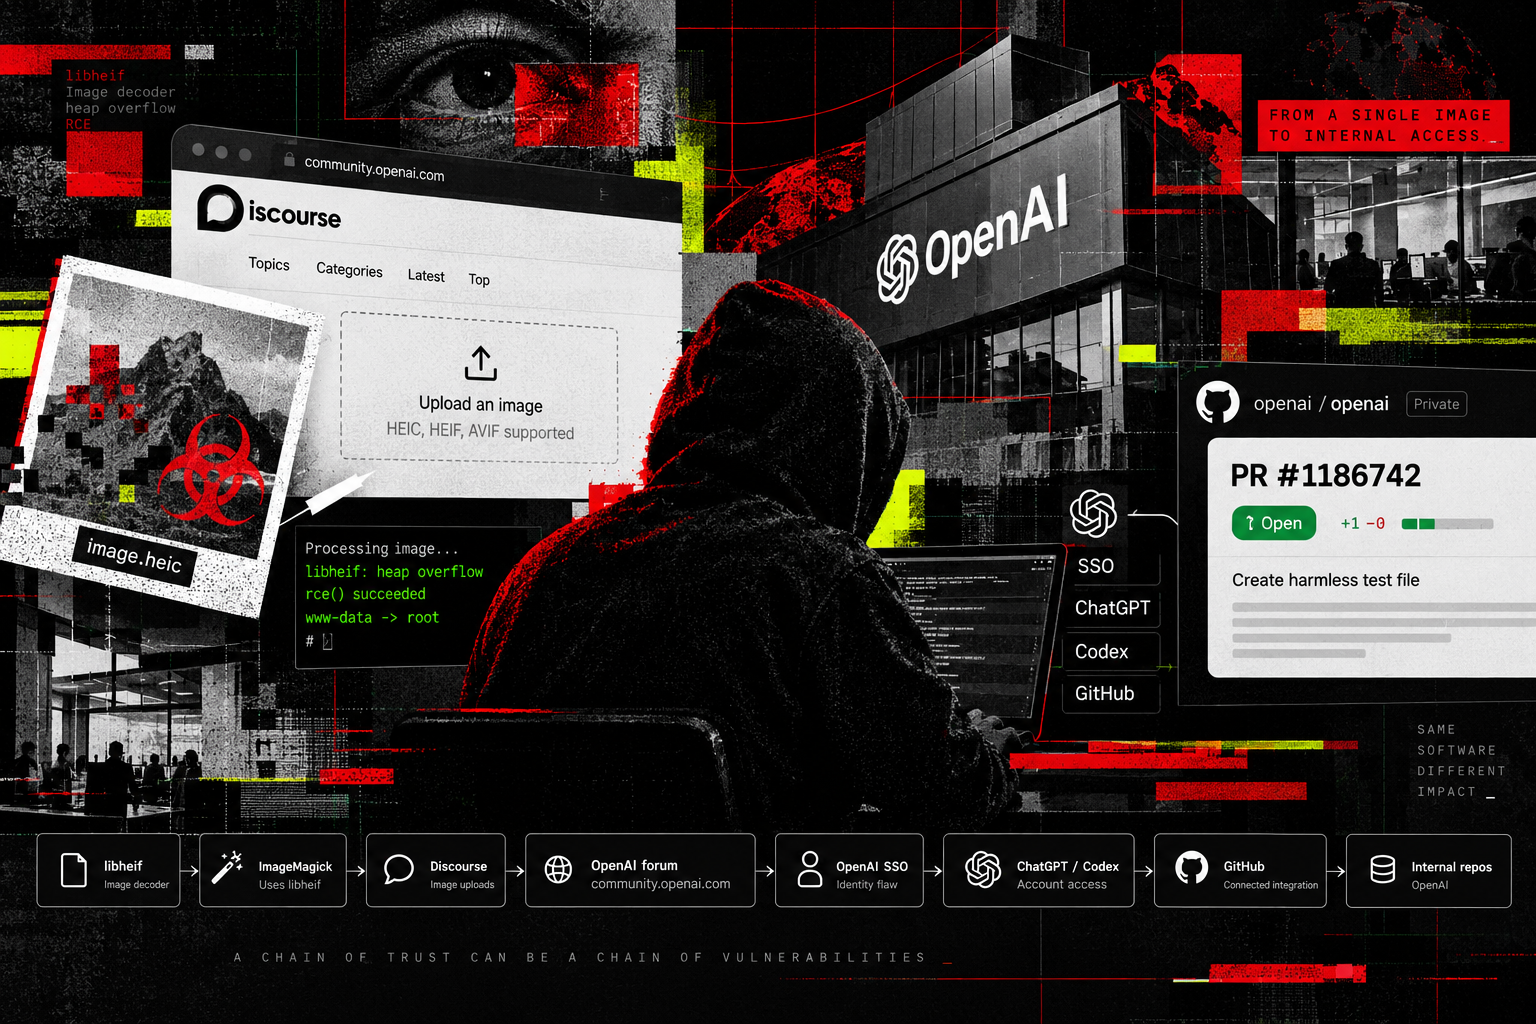
#سلسلة الهجوم باختصار
المسار الذي وصفه الباحثون لم يعتمد على ثغرة واحدة، بل على ربط عدد من المكونات والثغرات عبر طبقات مختلفة:
libheif— خلل في Decoder الخاص بالصور.Debian— غياب Backport أمني في الوقت المناسب.ImageMagick— استخدامlibheifلمعالجة الصور.Discourse— قبول ورفع صور المستخدمين.community.openai.com— منتدى OpenAI المبني علىDiscourse.OpenAI SSO— خلل في مسار الهوية.ChatGPT / Codex— الوصول إلى الحساب.GitHub— تكامل متصل بالحساب.- مستودعات OpenAI الداخلية.
ما يجعل السلسلة مهمة تقنيًا هو أن كل طبقة بمفردها لا تشرح الأثر النهائي. خلل الذاكرة أعطى موطئ قدم، لكن خلل الهوية هو الذي وسّع نطاق الاختراق من منتدى إلى خدمات أخرى مرتبطة بهوية المستخدم.
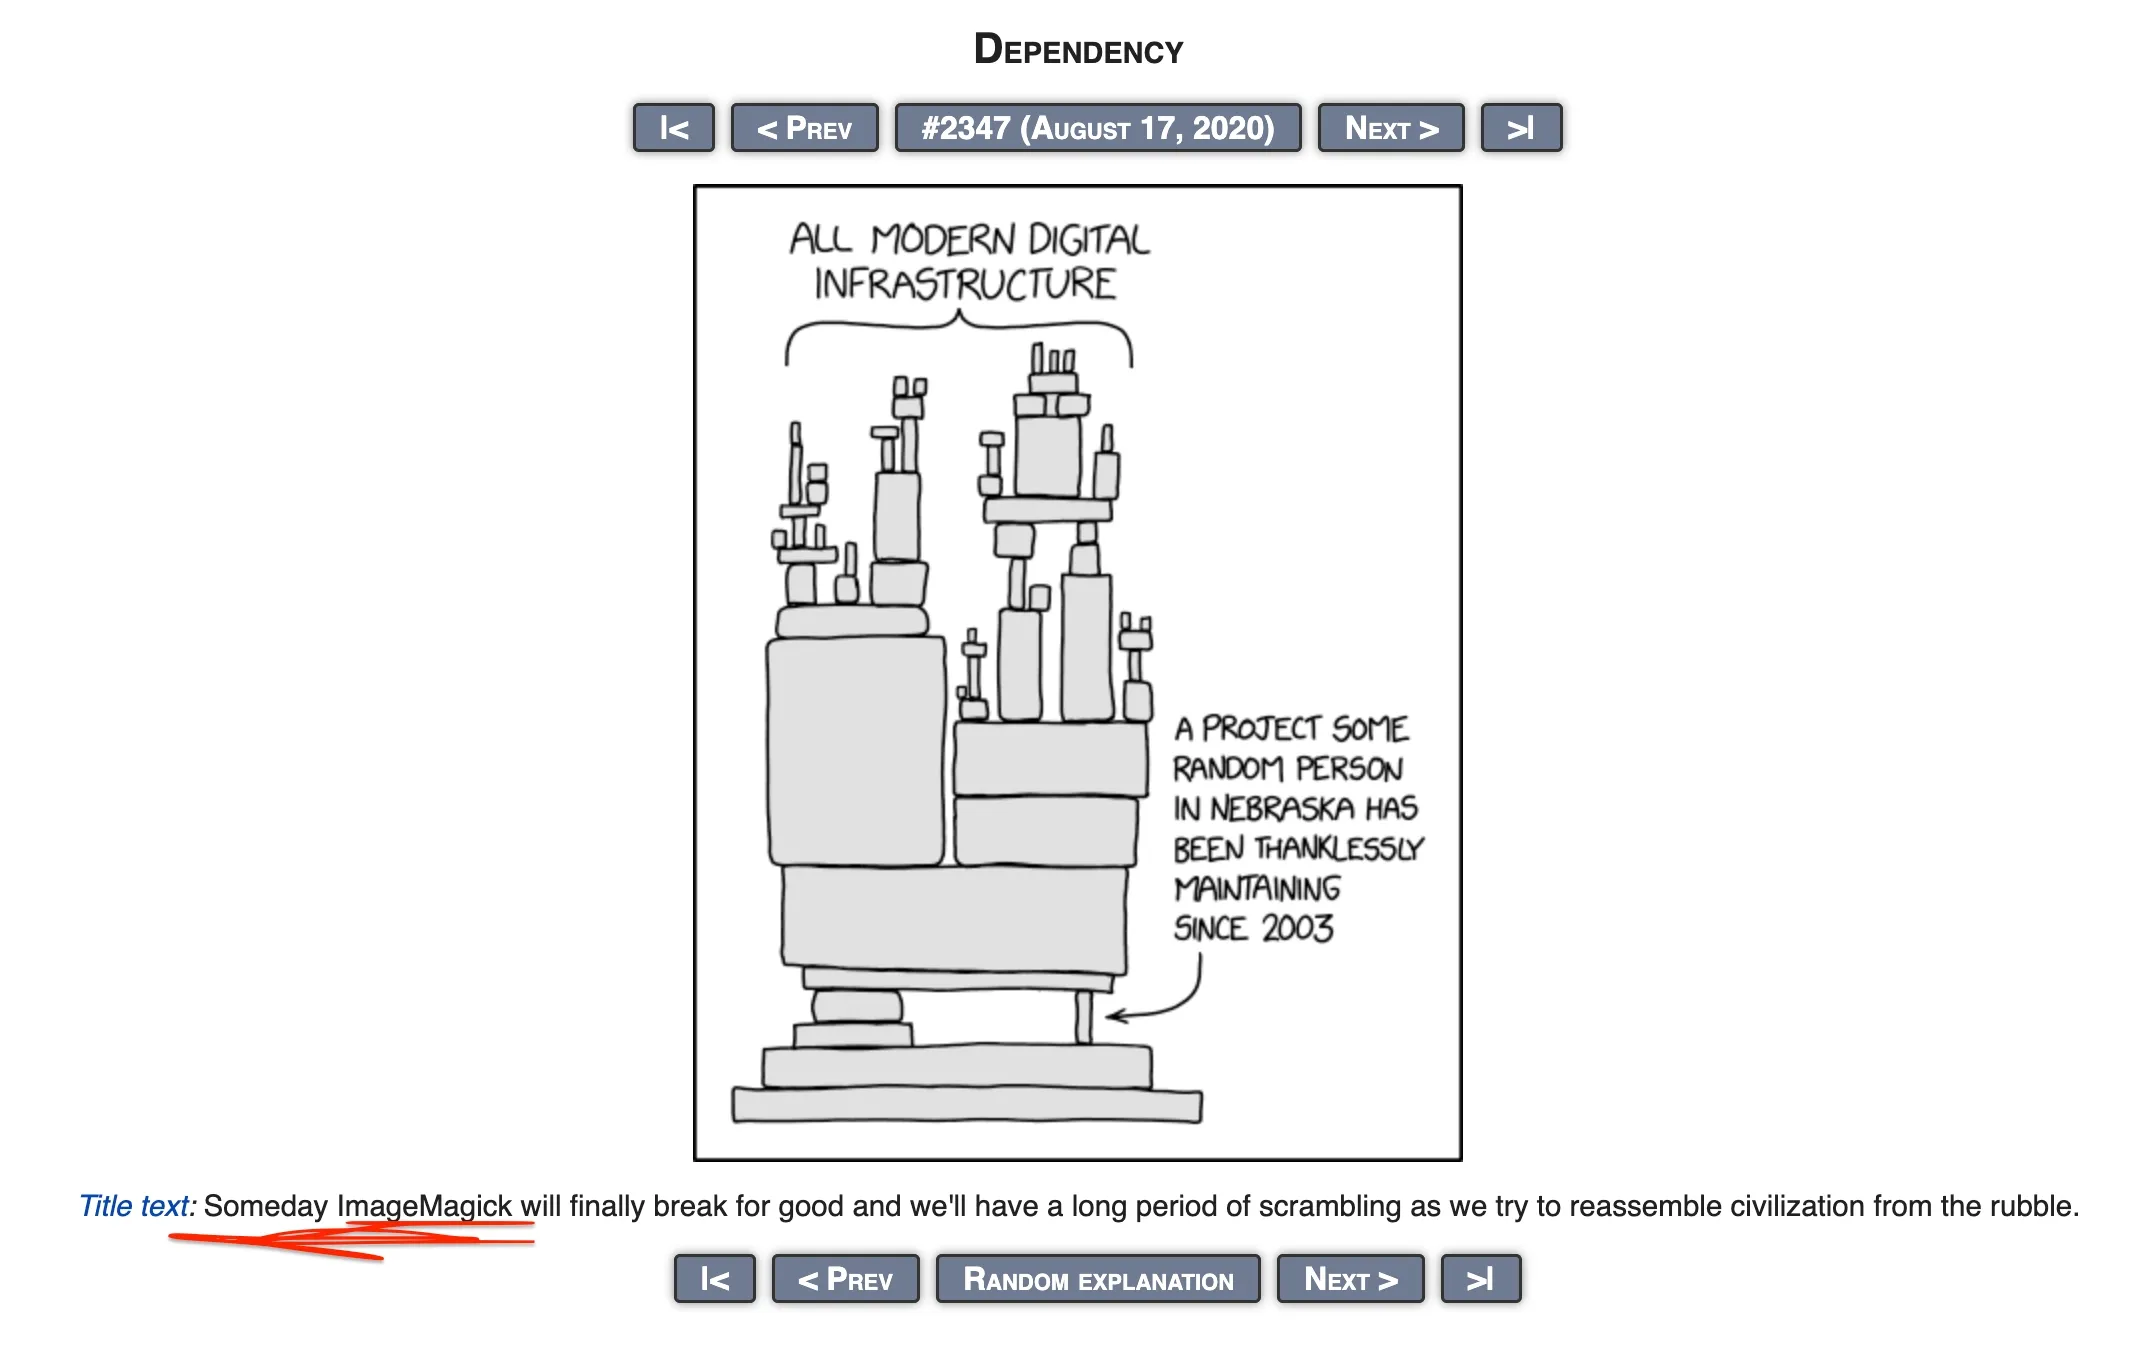
الرسم الذي أرفقه الباحثون في التقرير الأصلي لتوضيح كيف يمكن لاعتمادية برمجية صغيرة أن تصبح نقطة حساسة داخل عدد كبير من المنتجات والخدمات.
#لماذا أصبحت صور HEIF نقطة الدخول؟
بدأت المراجعة التقنية لمسار رفع الصور في Discourse في 23 يوليو 2026. وفق الباحثين، يتعامل Discourse عادةً مع الصور عبر FastImage لإجراء فحوصات أولية، لكن FastImage لا يدعم HEIF.
عندما تصل صورة من نوع HEIC أو HEIF، يتغير المسار: يقوم Discourse بتمريرها إلى أمر magick التابع لـ ImageMagick من أجل التحويل. هذا المسار جعل ملف الصورة الذي يرفعه المستخدم يصل في النهاية إلى محلل libheif نفسه.
هذه النقطة كانت حاسمة لأن libheif أصبحت تتعامل مباشرة مع محتوى يتحكم به المهاجم. وخلال مراجعة الحزمة المثبتة داخل صورة Docker الخاصة بـ Discourse، وجد الباحثون أن بعض الإصلاحات الأمنية الموجودة Upstream لم تُنقل كـ Backports إلى الحزمة المستخدمة.
النتيجة كانت heap buffer overflow يؤدي إلى قدرات Out-of-Bounds Read/Write أثناء فك ترميز صور HEIC.
#خلل موجود في المصدر لكن بلا CVE
بحسب التقرير، الشيفرة المتأثرة كانت قد تغيرت في المشروع الأصلي خلال العام السابق، لكن التغيير لم يُوثق على أنه إصلاح أمني ولم يحصل على CVE.
يرى الباحثون أن هذا قد يفسر سبب عدم وصول Backports الأمنية في الوقت المناسب إلى Debian 12 وDebian 13.
صورة Discourse المبنية على Debian 12 كانت تستخدم:
libheif 1.19.7
وفي ذلك الوقت كان Debian 13 يشحن:
libheif 1.19.8
بعد ذلك، نشر Debian تحديثًا أمنيًا لـ Debian 13 في 8 أغسطس 2026.
هذه الجزئية تكشف مشكلة معروفة في سلاسل الاعتماد البرمجية: وجود إصلاح في المشروع الأصلي لا يعني بالضرورة أن التوزيعات أو الصور المبنية فوقه قد حصلت عليه، خصوصًا عندما لا يُصنّف التغيير بوضوح كإصلاح أمني.
#من Memory Corruption إلى RCE
في 24 يوليو، عمل الباحثون على تحويل الخلل إلى استغلال عملي داخل ImageMagick/libheif. ووفق التقرير، نجحوا أولًا في الوصول إلى تنفيذ أوامر مع تعطيل ASLR، ثم حاولوا جعل الاستغلال موثوقًا ضد إعداد Discourse الافتراضي مع تفعيل ASLR.
التقرير يصف استخدام نماذج Claude ضمن عملية البحث. Opus 4.8 ساعد في تحليل الحزمة وتطوير الاستغلال الأولي، لكنه لم ينجح في الوصول إلى استغلال مستقر مع ASLR ضمن عدة جلسات.
لاحقًا، بعد صدور Claude Opus 5 في مساء اليوم نفسه، بدأ الباحثون جلسة جديدة. ووفق روايتهم، أنتج النموذج أولًا استغلالًا يعمل على ARM64 داخل جهاز Mac محلي خلال أقل من ثلاث ساعات، ثم جرى توجيهه لتكييف الاستغلال مع بيئة x86-64 وإعداد jemalloc المستخدم في Discourse.
بحلول الساعة 06:00 صباحًا في 25 يوليو، أكد الفريق وصوله إلى RCE محليًا من خلال رفع صورة.
بعد ذلك اختبروا السلسلة على نسخة Discourse Cloud خاصة بهم، وأظهر الاختبار القدرة على قراءة:
/etc/hosts
ثم استخدم الفريق سكربت الاستغلال الناتج للوصول إلى RCE على نسخة OpenAI من المنتدى.
#الاختراق لم يتوقف عند Discourse
لو انتهت القصة عند RCE داخل المنتدى، لبقي الأثر محصورًا في بيئة Discourse. لكن الباحثين كانوا مهتمين منذ البداية بمسار الهوية المرتبط بخيار:
Sign in with OpenAI
المنتدى يستخدم OpenAI SSO عبر:
auth.openai.com
وبعد السيطرة على المنتدى، تمكن الفريق — وفق التقرير — من تأكيد فرضية أخطر: يمكن تحويل اختراق خدمة تستخدم OpenAI SSO إلى استيلاء بلا تفاعل على حسابات ChatGPT وCodex لأعضاء نشطين في المنتدى.
الباحثون شددوا على أن هذا الجزء ليس عيبًا خاصًا بـ Discourse. بحسب التقرير، كان الخلل في OpenAI SSO نفسه، بينما كان اختراق Discourse مجرد وسيلة لإثبات إمكانية الوصول إليه.
بمعنى آخر، أي خدمة أولية أو تابعة لطرف ثالث تستخدم OpenAI SSO وتتعرض للاختراق كان من الممكن — وفق ما يذكره الباحثون — أن توفر المسار نفسه نحو حسابات OpenAI.
#من حساب موظف إلى GitHub الداخلي
بعد تأكيد أثر الاستيلاء على الحسابات، قام الفريق باختبار الأثر على حساب أحد موظفي OpenAI كان Codex لديه مرتبطًا بمؤسسة OpenAI على GitHub.
ولمنع الاطلاع على بيانات حساسة، لم يقرأ الباحثون مستودعات داخلية مباشرة. بدلًا من ذلك، أرسلوا Prompt إلى Codex الخاص بالموظف وطلبوا منه إنشاء Pull Request لإثبات أن الحساب المتأثر قادر فعليًا على تنفيذ إجراء داخل مستودع داخلي.
النتيجة كانت Pull Request غير ضار داخل:
openai/openai
ويشير التقرير إلى رقم:
PR #1186742
بعد هذا الإثبات، أوقف الفريق الاختبار الإضافي وحدّث بلاغه لدى OpenAI بتفاصيل الأثر.
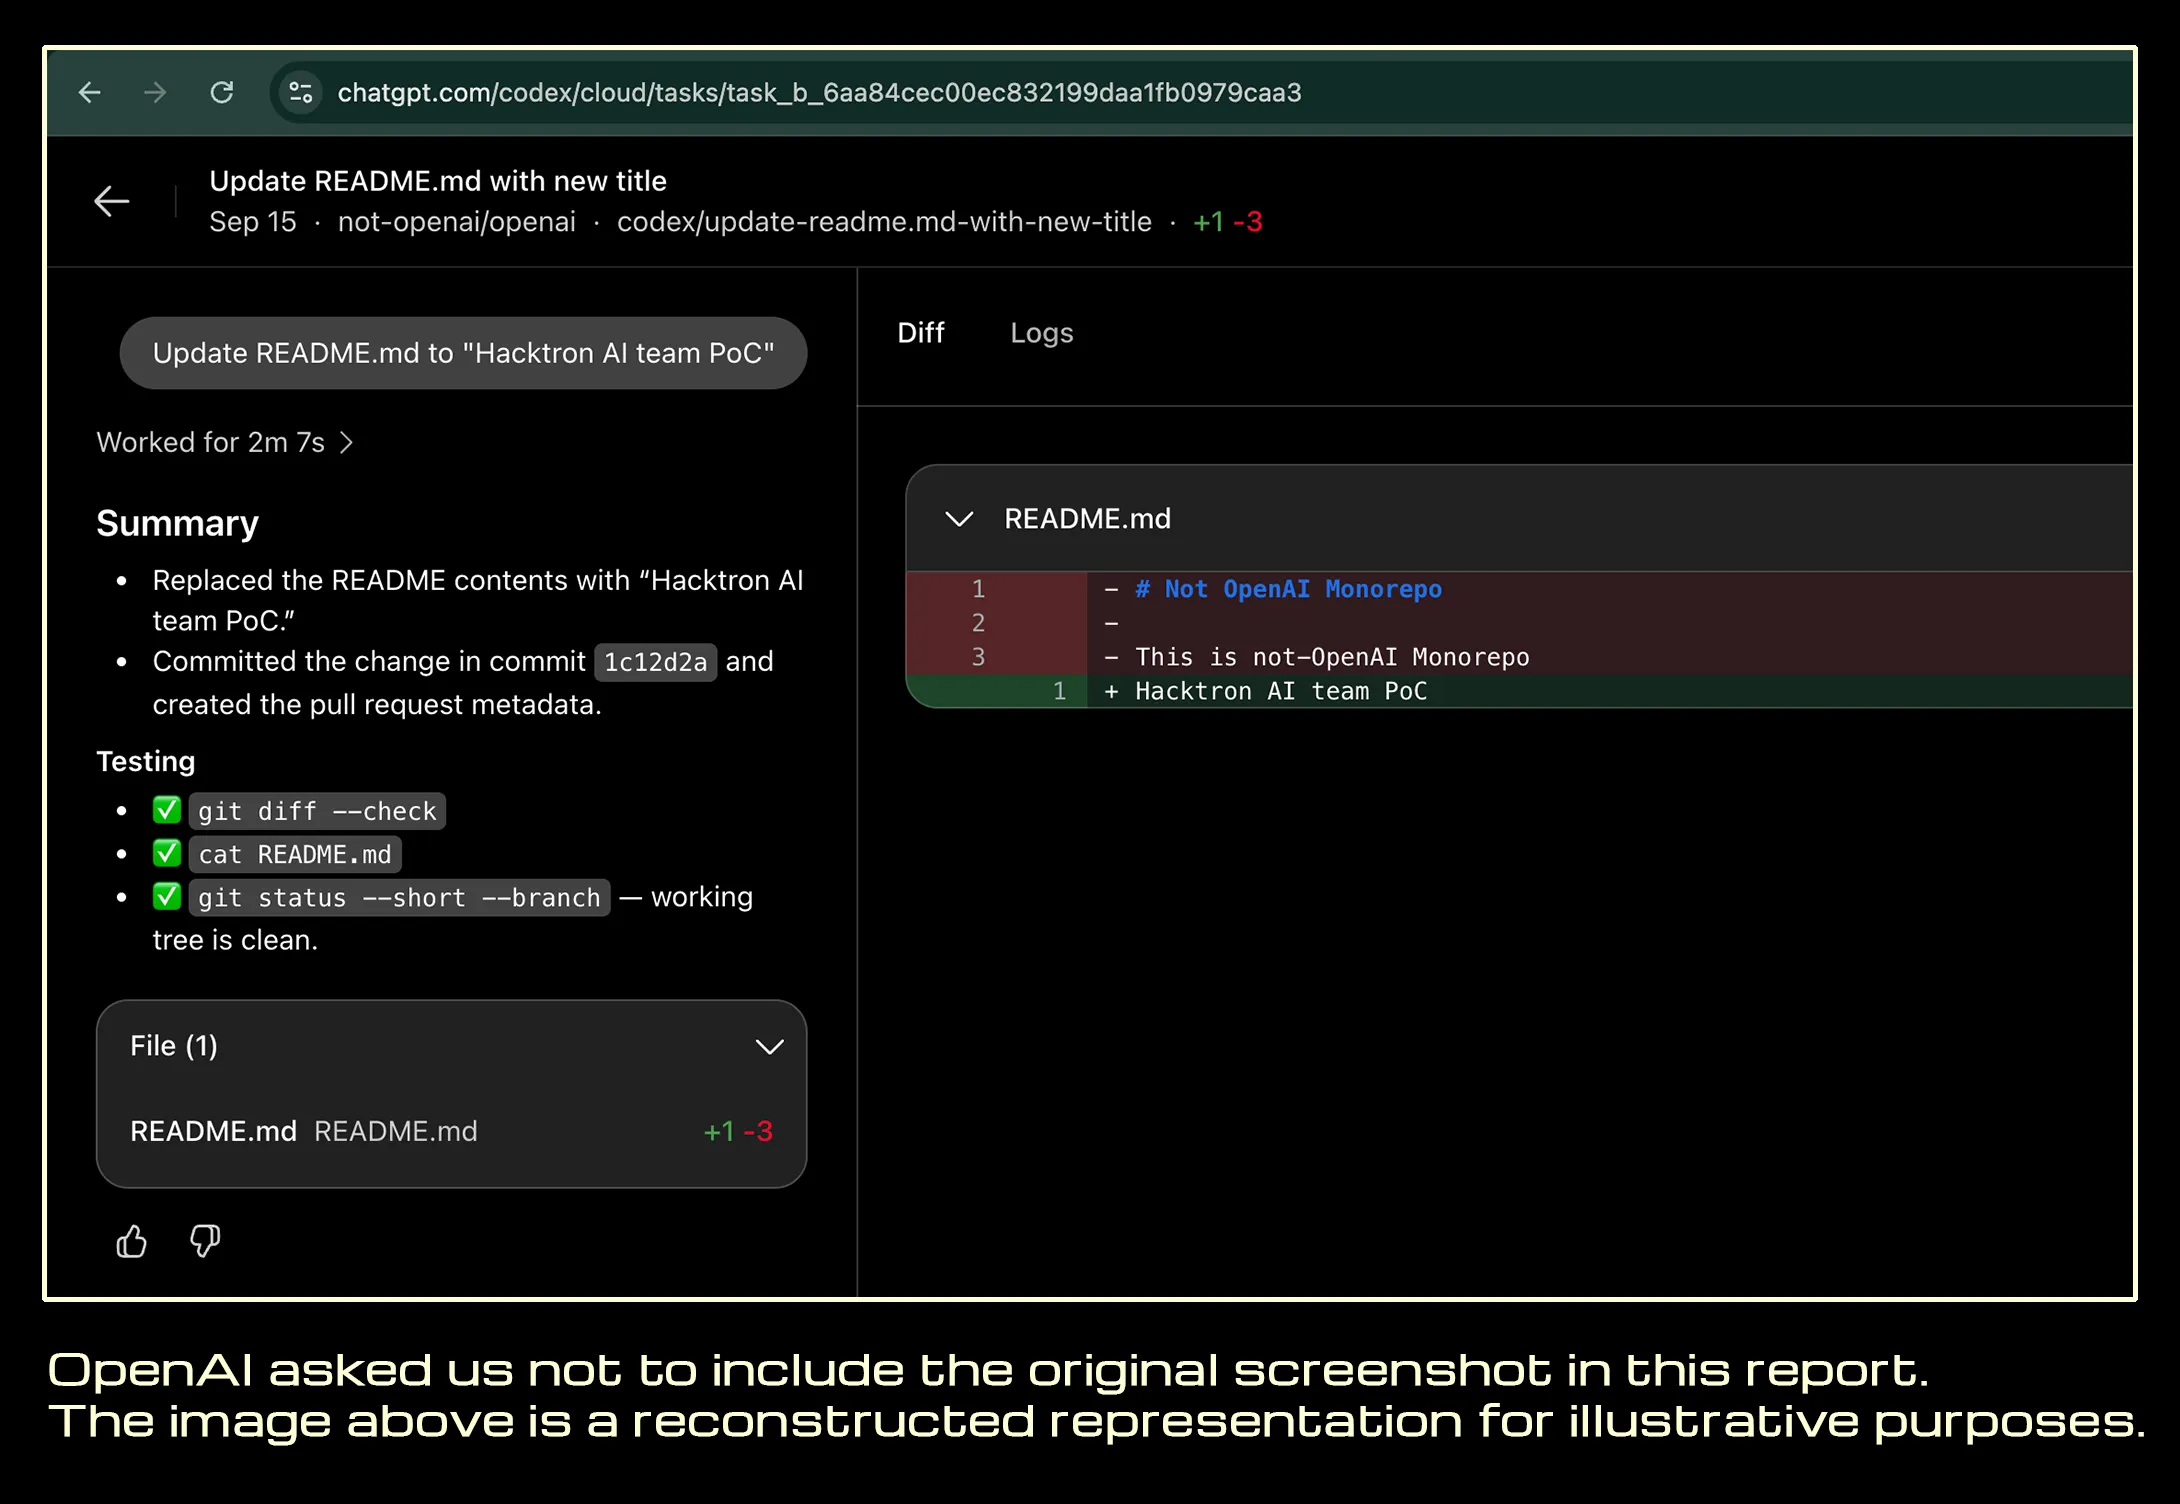
لقطة من التقرير الأصلي لإثبات الوصول إلى المستودع الداخلي. جرى حجب التفاصيل الحساسة بناءً على طلب OpenAI.
#لماذا هذا الخلل أخطر من مجرد RCE على منتدى؟
من منظور تقني، RCE هو نقطة السيطرة الأولى، لكن الأثر الأوسع جاء من حدود الثقة بين الأنظمة.
المنتدى لم يكن خدمة معزولة؛ كان مرتبطًا بهوية OpenAI. وحسابات ChatGPT وCodex بدورها قد تكون مرتبطة بخدمات أخرى. لذلك انتقل الأثر عبر سلسلة من علاقات الثقة:
Image Upload → Image Processing → Discourse → SSO → ChatGPT/Codex → Connected Services
وهنا تتحول المشكلة من ثغرة Memory Safety داخل مكتبة صور إلى مسألة Identity Security وAccess Control وThird-Party Risk في الوقت نفسه.
أي مؤسسة تعتمد على SSO أو على تكاملات بين الخدمات تحتاج إلى النظر إلى الخدمة الأقل حساسية في السلسلة باعتبارها جزءًا من سطح الهجوم على الخدمة الأعلى حساسية، لأن اختراق مكوّن جانبي قد يتحول إلى اختراق هوية مركزية إذا كانت حدود الثقة غير مصممة بشكل صحيح.
#أقل من 72 ساعة من الاكتشاف إلى الوصول الداخلي
التقرير يضع تسلسلًا زمنيًا دقيقًا للحادثة:
| التاريخ والوقت | الحدث |
|---|---|
| 25 يوليو 2026، 05:00–06:00 UTC | حصول فريق Hacktron على RCE ووصول إداري إلى بيئة Discourse على community.openai.com. |
| 25 يوليو 2026، 08:00–10:00 UTC | إرسال البلاغ عبر برنامج OpenAI للـ Bug Bounty على Bugcrowd بعد تأكيد الأثر عبر أكثر من منتج. |
| 25 يوليو 2026، 13:30–15:30 UTC | الوصول إلى حساب موظف في OpenAI وإنشاء Pull Request غير ضار داخل مستودع داخلي لإثبات الأثر، ثم إيقاف الاختبار. |
| 25 يوليو 2026، 22:49:45 UTC | OpenAI يؤكد إصلاح المشكلة من جهته، بعد نحو 14 ساعة من البلاغ الأولي. |
| 25 يوليو 2026 | إرسال تقرير منفصل إلى Discourse عبر HackerOne. |
| 26 يوليو 2026 | رد Discourse على البلاغ. |
| 27 يوليو 2026 | تجهيز الإصلاح وإضافة Sandboxing لمعالجة الصور كطبقة دفاع إضافية. |
| 28 يوليو 2026 | نشر التنبيه الأمني GHSA-vhm9-85gw-x335. |
| 1 سبتمبر 2026 | OpenAI يدفع مكافأة قدرها $6,500 ويغلق البلاغ باعتباره محلولًا. |
OpenAI أوضحت في تعليقها على المكافأة أن الاختبار ضد community.openai.com المستضاف على Discourse كان مستبعدًا صراحةً من برنامج Bug Bounty، وأن المكافأة تخص اكتشاف المشكلة على جانب OpenAI، وليس النشاط المتعلق بـ Discourse.
#دور الذكاء الاصطناعي في تطوير الاستغلال
أحد المحاور الأساسية في تقرير Hacktron لم يكن الثغرة وحدها، بل الاقتصاد الجديد لتطوير الاستغلال.
المشروع الأوسع الذي أطلق عليه الباحثون اسم HEIF Heist استهدف بيئات متعددة تعتمد على libheif، منها Slack وMeta وGitHub Enterprise وأطر مثل Next.js وAstro وGatsby.
بحسب التقرير، استغرق المشروع نحو شهرين، وشارك فيه ثلاثة باحثين، وبلغت تكلفة Tokens أقل من $3,000 إجمالًا. أما تكييف الاستغلال مع كل شركة جديدة فكان يستغرق عادة يومًا أو يومين.
يشير الباحثون أيضًا إلى فارق ملحوظ بين النماذج التي استخدموها. Opus 4.8 واجه صعوبة في جعل الاستغلال يعمل بثبات مع ASLR، بينما نجح Opus 5 خلال ساعات من صدوره في تجاوز المشكلة نفسها. ويقول التقرير إنهم لاحظوا قفزة إضافية لاحقًا مع GPT-5.6 Sol عند محاولة استغلال الهدف دون معرفة مسبقة تقريبًا عن نسخته أو بيئته.
هذه العملية لم تكن، بحسب وصفهم، اختراقًا ذاتيًا بالكامل. التوجيه البشري المتخصص بقي عنصرًا مهمًا، لكن النماذج قلّصت حجم العمل اللازم لتحويل Memory Corruption إلى Leak أو Shell أو استغلال قابل للتكييف مع بيئات مختلفة.
#مشكلة الرصد: آلاف الصور وتعطل المعالجات
في المشروع الأوسع، يقول الباحثون إن عمليات الاختبار بدأت لدى كل هدف من رفع صورة. ومن هناك جرى تحويل خلل الذاكرة إلى Memory Leak أو Shell، وغالبًا من دون معرفة إصدار libheif أو libc أو تفاصيل بيئة النشر مسبقًا.
ويذكر التقرير أن النماذج كانت تبدأ بمعلومات محدودة جدًا ثم تتكيف مع كل بيئة خلال يوم أو يومين.
الأكثر لفتًا للانتباه أن الباحثين يقولون إنهم لا يعرفون شركة اكتشفت النشاط باستثناء Shopify، رغم إرسال آلاف الصور وتكرار انهيار أنظمة معالجة الصور.
من زاوية Security Monitoring وIncident Response، هذه نقطة مهمة: انهيار Image Processor بشكل متكرر، أو ازدياد الأخطاء ضمن مسار فك ترميز الصور، قد يكون إشارة أمنية ذات قيمة أعلى مما يوحي به ظاهرها التشغيلي.
#الإصدارات المتأثرة ليست فرعًا واحدًا
الباحثون يوضحون أن HEIF Heist لا يتعلق بإصدار واحد بعينه، بل بمنظومة ثغرات عبر عدة عائلات إصدار، منها:
1.19.x
1.20.x
1.22.x
1.23.x
ووفق التقرير، فإن أي Deployment لا يحتوي على أحدث الإصلاحات الأمنية Upstream قد يكون معرضًا للتأثر.
حتى 14 سبتمبر 2026، كان أحدث إصدار أمني Upstream من libheif هو:
v1.23.4
ويشير التقرير إلى أن v1.23.2 تم تجاوزه بإصلاحات أمنية لاحقة. كما يحذر من الاعتماد على رقم الإصدار وحده، لأن بعض توزيعات Linux قد تحمل Backports أمنية مع الاحتفاظ برقم إصدار أقدم.
#الإصلاح والتخفيف
بالنسبة لمستخدمي Discourse المستضاف ذاتيًا، كان تنبيه الباحثين واضحًا: تحديث واجهة الويب وحده قد لا يستبدل صورة Docker الأساسية التي تحتوي على الحزمة المتأثرة.
أوصى التنبيه بتنفيذ:
cd /var/discourse
git pull
./launcher rebuild app
أما عملاء Discourse-hosted فقد جرى إصلاحهم بالفعل بحسب التقرير.
كما أوصى الباحثون بتحديث حزم:
libheif
libde265
من قناة التحديثات الأمنية الخاصة بالتوزيعة أو من إصدار Upstream مصحح.
وبسبب تعقيد ISO Base Media File Format واستمرار تطور Decoders، اقترح التقرير استخدام Defense in Depth عبر تعطيل فك ترميز HEIF/AVIF غير الموثوق عندما لا تكون الحاجة إليه قائمة، أو تشغيل مسارات معالجة الصور داخل Sandboxes مؤقتة ومعزولة ومشددة.
كما أشار إلى أن ImageMagick يدعم سياسات أمنية تسمح بتقييد أنواع الملفات المقبولة واستهلاك الموارد.
#ماذا تكشف هذه السلسلة عن المخاطر؟
المشكلة لم تكن مكتبة صور وحدها، ولا إعداد SSO وحده، ولا تكامل GitHub وحده. الخطر ظهر عند اجتماعها ضمن سلسلة ثقة واحدة.
من منظور Identity Security، استطاعت ثغرة في خدمة جانبية أن تؤثر على هوية تستخدم للوصول إلى خدمات ذات حساسية أعلى. ومن منظور Third-Party Risk، فإن أمان الخدمة المركزية لم يعد يعتمد فقط على كودها، بل على كل خدمة تستخدم هويتها أو تتصل بها.
أما من زاوية Data Protection وAccess Control، فتكاملات مثل GitHub وSlack والبريد الإلكتروني توسّع أثر اختراق الحساب لأن الحساب لا يمثل جلسة واحدة داخل تطبيق واحد، بل يصبح نقطة عبور إلى مجموعة من الأنظمة المتصلة.
لهذا فإن تقييم الخطر لا ينبغي أن يتوقف عند سؤال: «ما الذي يمكن أن يفعله المهاجم داخل المنتدى؟». السؤال الأدق هو: «ما الثقة التي يحملها هذا المنتدى معه إلى الأنظمة الأخرى؟»
#المصادر
- Hacktron Research: Hacking OpenAI
- HEIF Heist
- Discourse Security Advisory — GHSA-vhm9-85gw-x335
- Discourse: Support for HEIC images
- libheif upstream commit
- Debian DSA-6417-1: libheif security update
- Anthropic: Introducing Claude Opus 5
- RAND: A Playbook for Securing AI Model Weights
- libheif v1.23.4 security maintenance release
- ImageMagick Security Policy
القصة هنا لا تنتهي عند حقيقة أن صورة HEIF وصلت إلى RCE. القيمة الأهم في هذه السلسلة هي أن خطأ Memory Safety داخل Dependency منخفضة المستوى استطاع العبور عبر طبقات التطبيق والهوية والتكاملات حتى وصل إلى مستودع داخلي. حدود الأمان الفعلية لم تكن عند Discourse أو ChatGPT أو GitHub كلٌ على حدة، بل عند الروابط والثقة المتبادلة بينها.